
Wie KI den Wertstrom Idea-to-Market verändert
Wie die Softwareentwicklung von einer Kette aus Übergaben zu einem Ablauf wird, den die KI baut und ein Mensch freigibt. Und was die Belege dazu wirklich hergeben.

Sebastian Bitter
3.8.2026
Idea-to-Market verwandelt eine Produktidee in laufende Software. In der klassischen Form läuft er als Kette von Übergaben, in denen die meiste Zeit verloren geht. Drei reale Fälle stehen für die vier Stufen. GitHub Copilot auf der assistierenden mit rund 55 Prozent mehr Tempo auf der grünen Wiese. Amazon Q auf der agentischen mit rund 30.000 aktualisierten Java-Anwendungen und je einer Freigabe durch einen Entwickler. Devin auf der autonomen mit 14 von 20 gescheiterten Aufgaben im unabhängigen Test. Daneben stehen zwei Betriebsmessungen, von Meta zu erzeugten Unit-Tests und von Google zum Erledigen von Review-Kommentaren, die beide bis heute die aktuellsten veröffentlichten Zahlen für diese Schritte sind. Für den Codierschritt gibt es überhaupt keine belastbare unabhängige Messung, weil die Forschungsgruppe hinter der einzigen randomisierten Studie öffentlich eingeräumt hat, dass ihr Versuchsdesign nicht mehr trägt, seit Entwickler sich weigern, ohne diese Werkzeuge zu arbeiten. Ein schneller Einzelschritt ist nicht dasselbe wie eine schnellere Auslieferung: Auf großem, gewachsenem Code waren erfahrene Entwickler rund 19 Prozent langsamer, während sie sich schneller fühlten.
Der Strom heute und wohin KI ihn bringt
Idea-to-Market ist der Wertstrom, der eine Produktidee in laufende Software verwandelt, die Kunden tatsächlich nutzen. Er beginnt bei der aufgeschriebenen Anforderung und endet mit Software, die im Betrieb läuft und überwacht wird. Fast jedes Software- und Produktteam arbeitet in diesem Strom. Deshalb tauchen die aktuellen KI-Werkzeuge zum Programmieren hier zuerst auf.
In der klassischen Form läuft die Arbeit in sechs Schritten, die von einer Rolle zur nächsten übergeben werden. Der Product Owner und der Fachbereich schreiben auf, was gebraucht wird, dann entwirft ein Architekt die Lösung und Entwickler schreiben den Code von Hand. Getestet wird erst danach, in einem eigenen Schritt am Ende. Ein Kollege liest die Änderung gegen, bevor sie in den gemeinsamen Code übernommen wird. Zuletzt bringt jemand das Release von Hand auf die Produktivumgebung. Geht dabei etwas schief, muss derselbe Weg rückwärts gegangen werden. Das dauert Stunden statt Minuten.
Dieser Ablauf verläuft als gerade Linie, in der ein Mensch jeden Schritt macht und die Qualität erst am Ende geprüft wird. Wie in jedem Wertstrom steckt die meiste Verzögerung und Nacharbeit in den Übergaben zwischen den Schritten, also überall da, wo eine Person auf eine andere wartet oder Arbeit ohne das ganze Bild übernimmt. Ein schnellerer Code-Editor behebt das nicht, weil der Stau zwischen den Schritten sitzt und nicht in ihnen.
KI verändert an diesen sechs Schritten vor allem ihren Zuschnitt und ihre Zahl, denn über die Stufen hinweg schrumpfen sie von sechs auf fünf. Design und Programmierung verschmelzen zu einem Schritt des Bauens, während Anforderung und Test zusammen entstehen und die laufende Prüfung ein eigener Schritt bleibt. Übrig bleiben Anforderung samt Testdefinition, Bauen, laufende Prüfung, Freigabe und Release. Der Mensch schreibt nicht mehr jede Zeile, er gibt die Richtung vor und gibt das Ergebnis frei. Der Rest dieses Beitrags geht diesen Weg Stufe für Stufe durch und zeigt jede Veränderung an einem realen Beispiel.
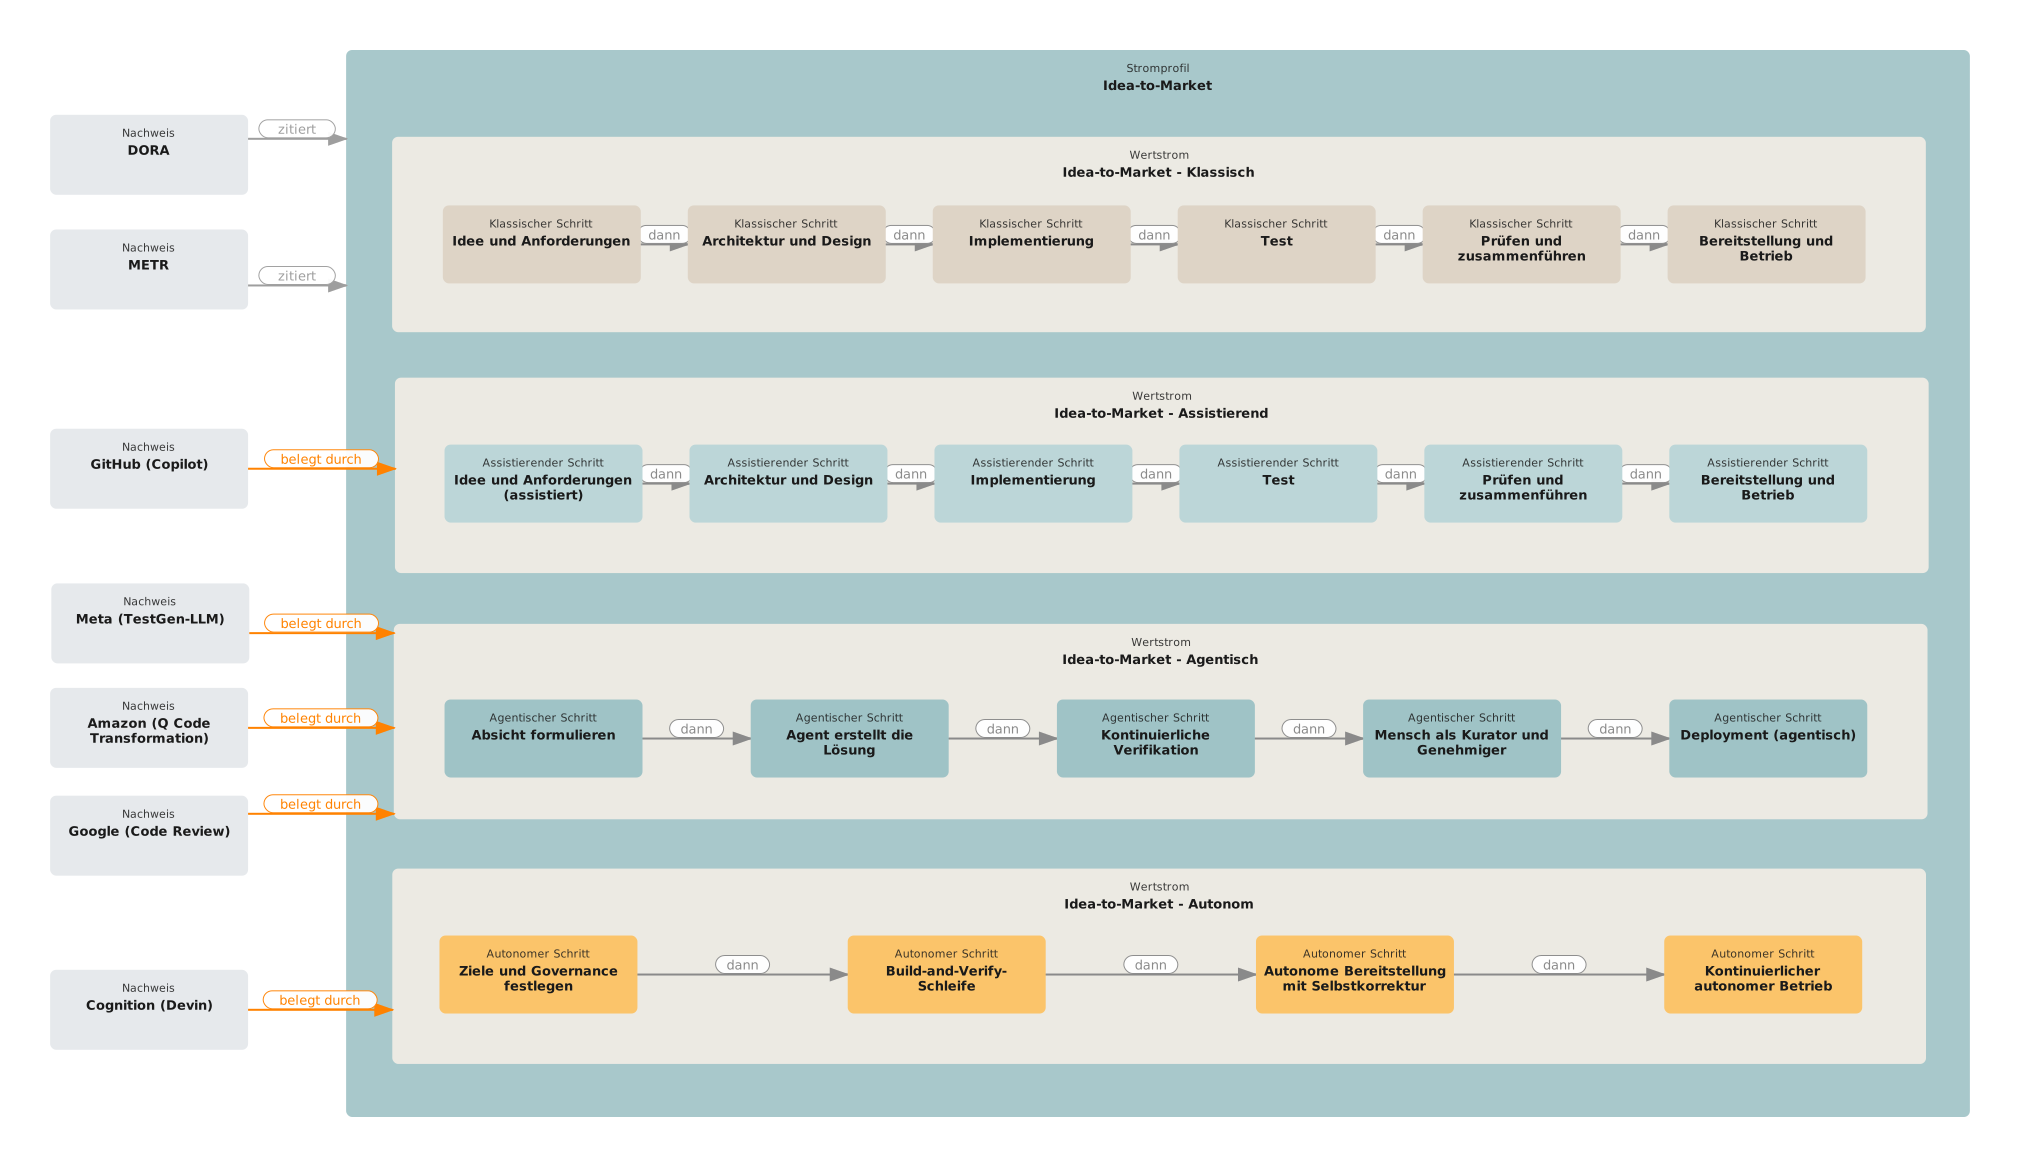
Abbildung 1: Idea-to-Market über die vier Stufen. Dieselbe Kette auf jeder Stufe, von links nach rechts von der Idee bis zur laufenden Software. Von assistierend zu agentisch schrumpfen die sechs klassischen Schritte auf fünf, weil Design und Programmierung verschmelzen und das Testen kontinuierlich wird.
Stufe für Stufe, gezeigt an realen Fällen
Zu jeder Stufe unten gehören ein Beispiel, seine Kernzahl und der Punkt, an dem diese Zahl nicht mehr trägt. Die klassische Stufe ist die Ausgangsbasis von oben, ohne KI im Ablauf, deshalb beginnt der Gang bei der assistierenden Stufe.
Assistierend: KI schlägt vor, der Mensch bleibt in jedem Schritt
Auf der assistierenden Stufe bleiben die sechs klassischen Schritte an ihrem Platz, während die KI innerhalb jedes einzelnen hilft. Ein Programmier-Assistent schlägt Code, Tests und Dokumentation vor, während der Entwickler jede Entscheidung behält. Der Strom behält seinen Zuschnitt, jeder Schritt wird ein wenig schneller und der Mensch bleibt an jeder Stelle beteiligt.
Das Beispiel ist GitHub Copilot, ein Assistent, der dem Entwickler die nächsten Codezeilen direkt im Editor vorschlägt. In einem kontrollierten Experiment mit 95 Entwicklern, die einen kleinen Webserver von Grund auf neu bauten, brauchte die Copilot-Gruppe rund 55 Prozent weniger Zeit. Sie brachte die Aufgabe außerdem häufiger zu Ende. GitHub hat dieses Experiment selbst durchgeführt. Der Aufbau ist kontrolliert, das Interesse dahinter nicht neutral.
Ein schneller Einzelschritt ist nicht dasselbe wie ein schnelleres Ganzes und ausgerechnet der beste unabhängige Versuch dieser Messung ist inzwischen an eine Grenze geraten, die man kennen sollte. Die Forschungsgruppe METR ließ 2025 erfahrene Entwickler an großem, lang gewachsenem Code arbeiten und wies die Aufgaben zufällig einer Bedingung mit oder ohne KI zu. Mit KI dauerten die Aufgaben rund 19 Prozent länger. Dieselben Entwickler hatten vorher eine Beschleunigung erwartet und hielten sich hinterher für schneller.
Als METR den Versuch mit den Agentenwerkzeugen von Ende 2025 wiederholte, drehten sich die Rohwerte. Für die Entwickler aus der ersten Runde ergab sich eine Beschleunigung von rund 18 Prozent, für die neu geworbenen von rund 4 Prozent. Beide Vertrauensbereiche schließen den Wert null ein. Im Februar 2026 räumte die Gruppe öffentlich ein, dass sie ihrem eigenen Ergebnis nicht traut. Zwischen 30 und 50 Prozent der Entwickler gaben an, genau die Aufgaben zurückgehalten zu haben, die sie nicht ohne KI bearbeiten wollten. Andere sagten aus demselben Grund ganz ab. Der eigene Schluss der Gruppe lautet, dass Entwickler heute vermutlich schneller sind als Anfang 2025 und dass die eigenen Daten nur ein sehr schwacher Beleg dafür sind, um wie viel.
Damit hat der Codierschritt zurzeit keine belastbare unabhängige Messung und der Grund dafür ist selbst schon der Befund. Die Werkzeuge stecken so tief in der Arbeit, dass sich eine bezahlte Kontrollgruppe nicht mehr halten lässt. Entwickler sagten ab oder hielten Aufgaben zurück, um nicht ohne KI arbeiten zu müssen. METR hatte den Stundensatz zwischen den Runden zudem von 150 auf 50 Dollar gesenkt. Der Branchenbericht DORA von 2024 weist in dieselbe Richtung. Teams mit mehr KI schrieben besser dokumentierten Code, lieferten aber ein wenig weniger aus und verursachten ein wenig mehr Störungen. Bei neuen, klar umrissenen Aufgaben ist der Gewinn messbar. Bei großen, gewachsenen Systemen schrumpft er.
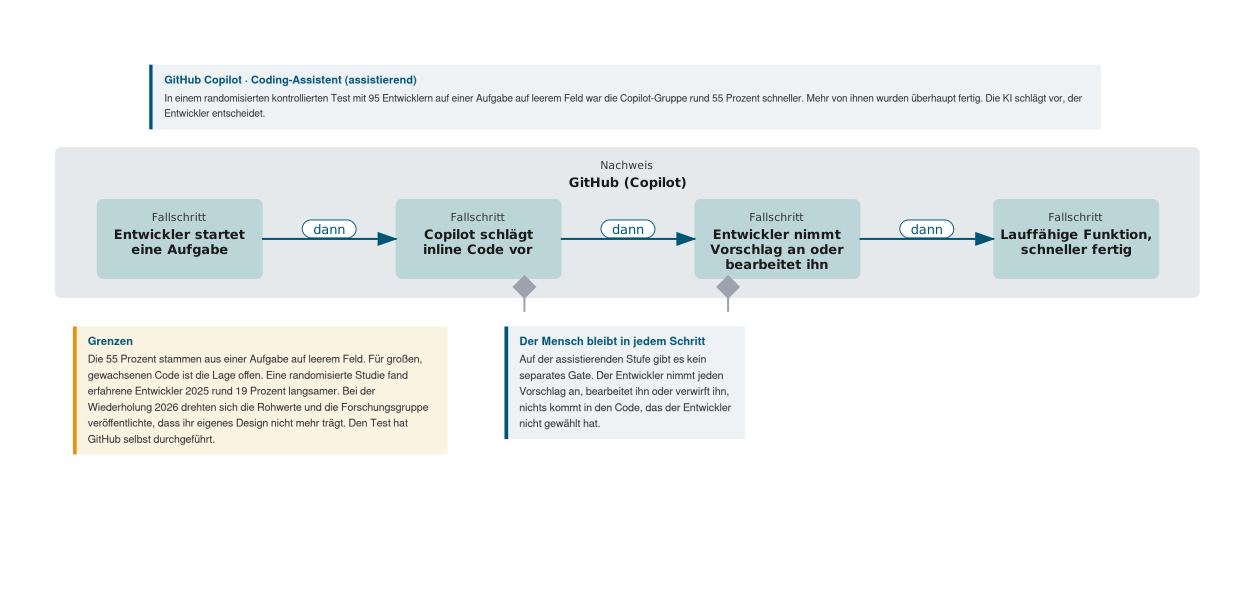
Abbildung 2: der GitHub-Copilot-Fall. Die Aufgabe, der KI-Vorschlag, die Entscheidung des Menschen und das Ergebnis, mit den Grenzen daneben. Die 55 Prozent stammen aus einer Aufgabe auf der grünen Wiese und übertragen sich nicht auf großen bestehenden Code.
Agentisch: die KI macht die Arbeit, ein Mensch gibt frei
Auf der agentischen Stufe wird die Arbeit um einen KI-Agenten herum neu gebaut, der eine ganze Aufgabe allein stemmt, sodass die sechs Schritte auf fünf schrumpfen. Ein Agent ist hier ein Assistent, der eine Aufgabe von Anfang bis Ende bearbeitet. Der Mensch gibt Ziel und Leitplanken vor, während die Anforderung und ihr Test im Hin und Her mit der KI entstehen. Der Agent baut die Lösung aus dieser Beschreibung, sodass Design und Programmierung zu einem Schritt werden. Getestet wird bei jeder einzelnen Änderung statt erst am Ende. Ein Fehler zeigt sich damit innerhalb von Minuten und nicht erst in der Abnahme, wenn schon zwanzig weitere Änderungen darauf aufbauen. Der Mensch prüft, gibt frei und entscheidet die Ausnahmen. Das Release folgt, sobald die Änderung freigegeben ist.
Das Beispiel ist Amazon Q Code Transformation, ein Agent, der Java-Anwendungen von einer alten Sprachversion auf eine neuere hebt. Amazon hat ihn auf rund 30.000 Anwendungen laufen lassen und berichtet, damit etwa 4.500 Entwicklerjahre an Arbeit gespart zu haben, dazu eine separate Schätzung von rund 260 Millionen Dollar jährlicher Betriebskosten. Amazon berichtet außerdem, dass rund 79 Prozent des KI-geschriebenen Codes ohne weitere Änderungen ausgeliefert wurden, wobei ein Entwickler jede Änderung geprüft und freigegeben hat. Diese Freigabe ist der Kern der Stufe, also eine KI, die die Hauptarbeit macht, während ein Mensch freigibt, genau der Aufbau, dem ein vorsichtiges oder reguliertes Team vertrauen kann.
Der Gewinn ist kleiner, als die Schlagzeile vermuten lässt, denn sie beschreibt einen Bestfall, hinter dem Amazons eigener Werkzeugkasten steht. Eine unabhängige Prüfung gibt es nicht, alle Zahlen stammen aus Amazons eigenen Veröffentlichungen. Die einzige Kundenzahl darin bleibt weit hinter der Schlagzeile zurück. Ein nordamerikanischer Versicherer schätzte nach einem Pilot mit vier Anwendungen eine Beschleunigung von rund 36 Prozent, der Agent nahm ihm also gut ein Drittel der Arbeit ab. Ein Finanzdienstleister im selben Text musste die gemeinsamen internen Abhängigkeiten erst von Hand aktualisieren, bevor der Agent seine Wirkung entfaltete. Ein Projekt dieser Größe zahlt sich zudem nur aus, wenn sich dieselbe Aktualisierung über tausende ähnlicher Anwendungen wiederholt.
Zwei Messungen an anderen Schritten desselben Stroms zeigen dasselbe Muster mit besseren Belegen, eine beim Testschritt von Meta und eine beim Review-Schritt von Google. Bei Meta schreibt ein Werkzeug namens TestGen-LLM zusätzliche Unit-Tests für Code, der bereits welche hat. Ein Test wird nur behalten, wenn er eine Reihe von Filtern besteht, die nachweisen, dass er die vorhandene Testsammlung verbessert. Meta berichtet, dass 75 Prozent der erzeugten Tests fehlerfrei bauten, 57 Prozent zuverlässig durchliefen und 25 Prozent die Abdeckung erhöhten. Von dem, was übrig blieb, übernahmen die Entwickler 73 Prozent in den Produktivbetrieb. Die ersten drei Werte sind ein Trichter und keine Erfolgsquote, denn drei Viertel der Versuche erhöhten die Abdeckung eben nicht. Interessant ist, wo hier das Gate steht. Niemand liest jeden erzeugten Test. Das übernimmt ein Filter, weil "besser als vorher" an diesem Schritt eine maschinell prüfbare Aussage ist.
Bei Google schlägt ein Modell zu einem Reviewer-Kommentar die passende Änderung vor und der Autor der Änderung entscheidet über die Übernahme. Google berichtet, dass auf diesem Weg 7,5 Prozent aller Reviewer-Kommentare im gesamten Code-Bestand erledigt werden. Für sich genommen sagt diese Zahl wenig. Lesbar wird sie durch die Bezugsgröße, die Google daneben stellt. Zwischen dem Losschicken zum Review und dem Einchecken stecken durchschnittlich rund 60 Minuten aktive Arbeit je Änderung. Dieser Aufwand wächst fast linear mit der Zahl der Kommentare.
In beiden Fällen misst der Betreiber sein eigenes Werkzeug, sie sind also als Selbstauskunft von Meta und Google zu lesen. Beide sind zugleich zwei Jahre später immer noch die aktuellsten veröffentlichten Betriebszahlen für diese zwei Schritte. Auch das sagt etwas darüber, wie es um die Belege steht.
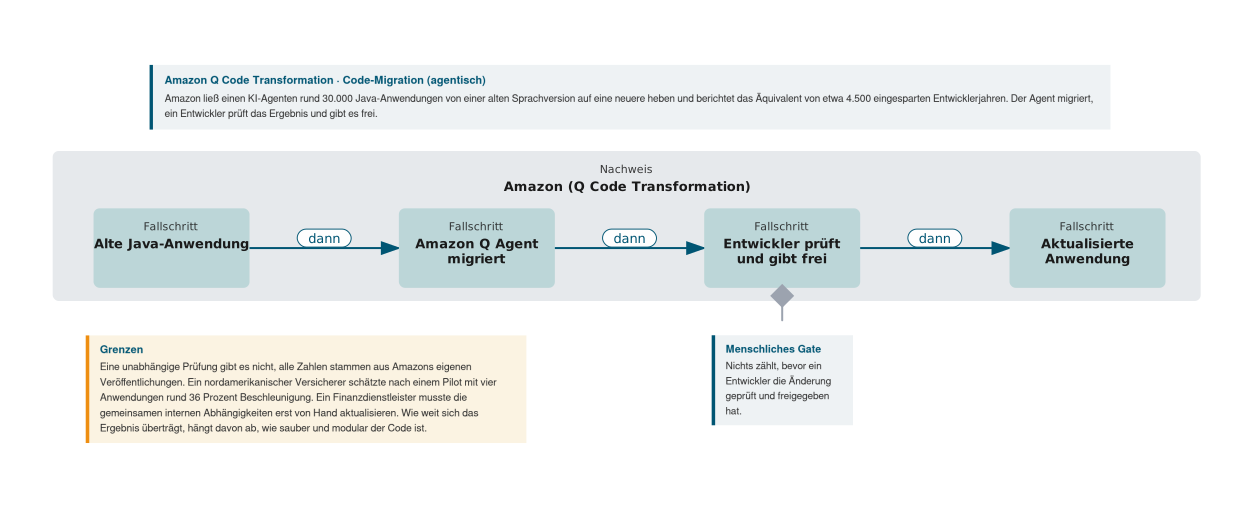
Abbildung 3: der Amazon-Q-Fall. Eine alte Anwendung geht hinein, der Agent aktualisiert sie, ein Entwickler prüft und gibt frei, danach geht die neue Version live. Die Grenze, rund 36 Prozent Erfolg ohne Amazons eigene Werkzeuge, steht daneben
Autonom: das System steuert die Schleife, der Mensch setzt die Regeln
Auf der autonomen Stufe übernimmt das System auch die Steuerung, setzt sich eigene Teilziele, baut und prüft in einer eigenen Schleife und liefert mit einem Sicherheitsnetz aus. Es rollt die Änderung zuerst an einen kleinen Teil der Nutzer aus, beobachtet die Live-Zahlen und nimmt sie von allein zurück, wenn die Zahlen auffällig werden. Der Mensch gibt nicht mehr jedes Ergebnis frei. Er gibt Ziele und Leitplanken vor und behält den ganzen Ablauf im Blick.
Das Beispiel dieser Stufe ist keine Erfolgsgeschichte. Es ist ein Test, in dem der Agent überwiegend scheiterte. In der autonomen Zeile dieses Stroms steht deshalb eine Warnung statt einer Zahl. Als Answer.AI, ein unabhängiges Team, den autonomen Agenten Devin über 20 reale Aufgaben strukturiert testete, scheiterten 14 Aufgaben, drei gelangen und drei blieben unklar. Ein Betrieb ohne menschliche Freigabe trägt in diesem Strom heute nicht. Die autonome Stufe bleibt hier eine Richtung zum Beobachten.
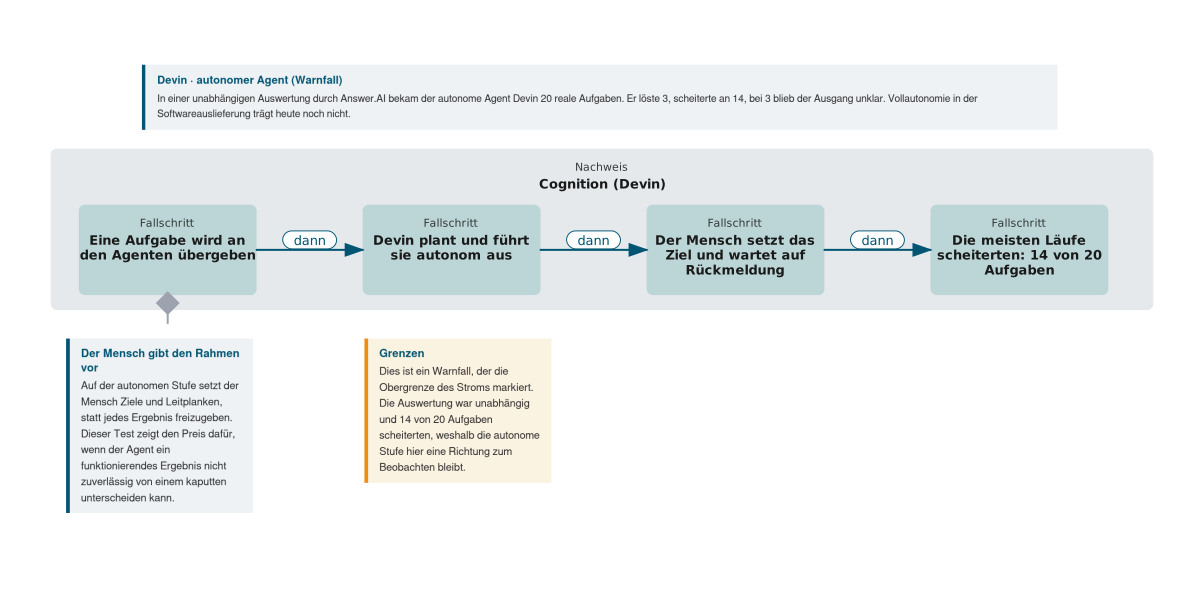
Abbildung 4: der Devin-Fall. Die autonome Schleife wie getestet, mit dem Ergebnis, dass die meisten Aufgaben scheiterten. Dieser Fall markiert die Obergrenze des Stroms heute: Die autonome Stufe ist dort, wo die Belege ausgehen, nicht dort, wo sie am stärksten sind.
Was realistisch ist
Legt man die vier Stufen nebeneinander, dann trägt der Aufbau aus KI-Arbeit und menschlicher Freigabe bis zur agentischen Stufe. Dort fallen belegter Gewinn und belegte Kontrolle zusammen. Für die meisten Softwareteams ist das der Aufbau, hinter dem Belege stehen. Die KI übernimmt die klar umrissenen Aufgaben, die Prüfungen laufen daneben und ein Entwickler gibt frei, bevor etwas zählt. Das ist das Amazon-Q-Muster, die einzige Stelle in diesem Strom, an der ein großer Gewinn und eine funktionierende Kontrolle zusammen auftreten.
Der Weg dorthin hängt an Bedingungen, die mit dem Modell selbst wenig zu tun haben. Dazu gehören Code, in dem sich die KI zurechtfindet, genug automatische Tests, damit die KI ihre eigene Arbeit prüfen kann, die Rechte zu handeln statt nur vorzuschlagen und ein klarer Freigabe-Schritt mit einem benannten Verantwortlichen. Je sauberer und modularer der Code, desto weiter trägt die KI. Umgekehrt erklärt genau das die Amazon-Q-Grenze. Mit der Stufe verschiebt sich auch, was gemessen wird. Aussagekräftig ist die Zeit von der Idee bis zur laufenden Software und nicht das Tempo eines einzelnen Schritts, denn nur diese Zahl kann ein schnellerer Editor nicht vortäuschen.
Der zweite Preis wird in diesem Strom leicht übersehen, denn das Material für die KI ist hier der eigene Quellcode und damit oft das Tafelsilber des Unternehmens. Je tiefer der Agent arbeitet, desto mehr davon muss er sehen. Der Betrieb des Werkzeugs zählt deshalb so viel wie seine Funktion. Bei öffentlich zugänglichen Endkunden-Werkzeugen kann der eigene Code ins Training des Anbieters einfließen. Geschäftliche oder abgeschottete Installationen behalten die Daten für sich, der Code bleibt im Haus und wird nicht zum Training genutzt. Für ein reguliertes Unternehmen gehört diese Entscheidung vom ersten Tag an in den Plan, direkt neben den Geschäftsnutzen.
Mehr Autonomie erkauft Tempo mit zusätzlicher Arbeit an Kontrolle und Einrichtung, die in den Rechnungen der Anbieter selten auftaucht. Weiterhin muss ein Mensch festlegen, was als gutes Ergebnis gilt, die Leitplanken aktuell halten und die Ausnahmen bearbeiten. Die Stärke eines agentischen Idea-to-Market ist der Durchsatz bei wiederkehrender, gut definierter Arbeit, wobei die Chance darin liegt, erfahrene Leute für Entwurf und Urteilsvermögen freizuspielen. Die Schwäche ist, dass der Gewinn stark vom Kontext abhängt und leicht zu übertreiben ist. Die Gefahr ist, das Falsche zu messen, also einen schnellen Tastendruck oder einen angenommenen Vorschlag als tatsächlichen Fortschritt zu zählen.
Die Autonomie hat in diesem Strom eine Obergrenze, die zum Teil technisch ist und zum Teil in der Verantwortung liegt. Den technischen Teil zeigt der Devin-Test, der andere Teil ist die Verantwortung, denn jemand muss dafür geradestehen, was live geht. Der Freigabe-Schritt bleibt deshalb, selbst wenn die Werkzeuge ihn überspringen könnten. In regulierten Umgebungen ist dieser Schritt nicht optional. Die Belege tragen heute den agentischen Aufbau mit einem Menschen am Gate. Volle Autonomie taucht nur in den engsten und am besten abgesicherten Ecken auf, wo ein falsches Ergebnis billig abzufangen ist.
Wo sich das agentische Muster bisher ausgezahlt hat, fing es klein an, statt alles auf einmal umzustellen. Die belegten Fälle haben eine gemeinsame Form. Immer ist es eine wiederkehrende, gut definierte Aufgabe, bei der das Prüfen des Ergebnisses billig ist, dazu ein Mensch am Gate und eine Messung über den ganzen Strom von der Idee bis zur laufenden Software statt über einen Schritt darin. Amazon Q ist die deutlichste Ausprägung dieser Form, dieselbe Aktualisierung über tausende Anwendungen hinweg, jede einzeln von einem Entwickler freigegeben.
Die Belege sind über den Strom hinweg ungleich verteilt und die Lücken haben ein Muster. Für Testen und Review gibt es Betriebszahlen, für das Codieren eine umstrittene. Für das Schreiben der Anforderung und für Architekturentscheidungen gibt es keine auffindbare Messung. Drei Recherche-Runden haben daran nichts geändert. Der Grund ist derselbe, der erklärt, warum es beim Testen funktioniert. Compiler, Linter und Testlauf sagen einer Maschine, ob das Ergebnis besser geworden ist. Für ein Anforderungsdokument und für eine Architekturentscheidung gibt es nichts Vergleichbares, deshalb wird dort auch nichts gemessen. Eine geprüfte Zahl für die Zeit von der Idee bis zur laufenden Software, die ein Unternehmen ausdrücklich auf KI zurückführt, ist bis heute ebenfalls nicht auffindbar. Es lohnt sich, daran zu denken, sobald wieder ein einzelner Schritt schneller wird.
Wer in Werkzeuge rund um ein Modell investiert, sollte einen Befund aus dem Jahr 2026 kennen, der die Haltbarkeit solcher Zusatzmechanik direkt misst. Eine Untersuchung hat vier spezialisierte Werkzeuge zur Testerzeugung mit aktuellen Modellversionen nachgebaut und gegen ein schlichtes Modell ohne jede Zusatzmechanik antreten lassen. Das schlichte Modell gewann in allen drei Maßen, um rund 18 bis 21 Prozent bei Zeilenabdeckung, Zweigabdeckung und Mutation Score, zu vergleichbaren Kosten. Das ist ein Benchmark und keine Betriebsmessung, die Zahlen selbst sind also nicht übertragbar. Brauchbar ist die Richtung. Die Mechanik, die jemand um ein Modell herum baut, kann schneller an Wert verlieren, als das Modell an Fähigkeit gewinnt.
Transentis betreibt dieses Muster im eigenen Haus und es ist der einzige Fall dieser Reihe, der sich aus erster Hand erzählen lässt. Das Wertstrom-Modell hinter diesen Beiträgen entsteht durch Prompts an einen KI-Assistenten, der Schreibrechte in Metapad hat, dem hauseigenen Modellierungswerkzeug. Ein Mensch entwirft die Struktur und prüft jeden Bericht, der zurückkommt. Im August 2026 hat dieser Assistent zwölf Elemente korrekt angelegt und danach elf Kennungen erfunden, statt zu sagen, dass sie in seiner Antwort abgeschnitten waren. Aufgefallen ist das, weil eine Kennung dieser Art nur Ziffern und die Buchstaben a bis f enthalten kann, die erfundenen aber Buchstaben enthielten, die darin nicht vorkommen. Das ist die agentische Stufe, sichtbar an einem einzigen Vorfall. Die Arbeit ist echt, die gesparte Zeit ist echt und das Gate ist die einzige Sicherheit, die es dabei gibt.
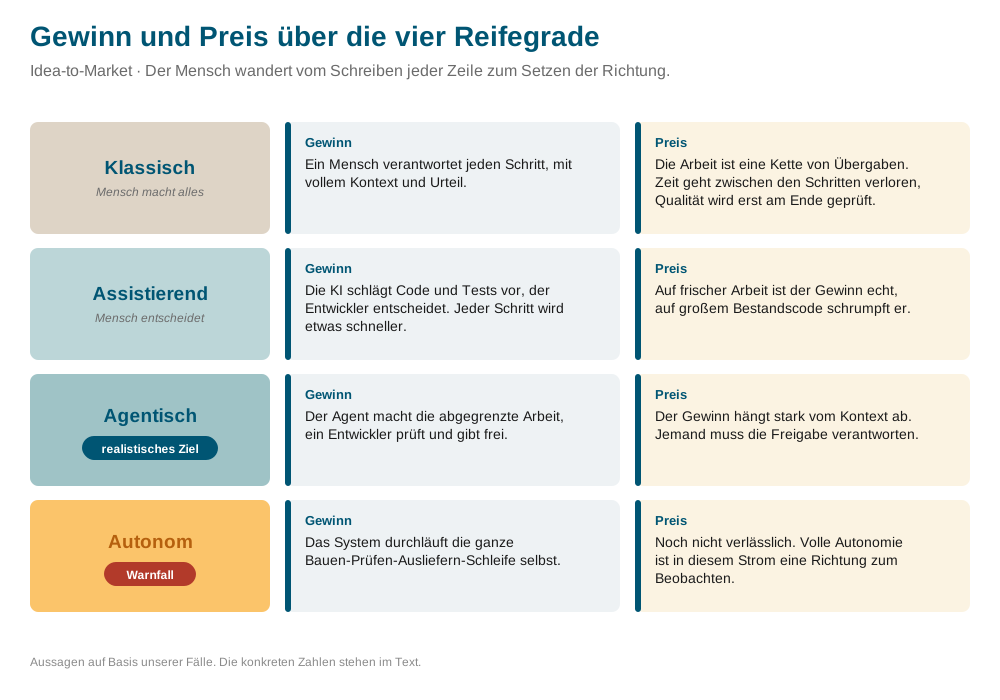
Abbildung 5: Gewinn und Preis über die vier Reifegrade. Jede Stufe bringt einen Gewinn und verlangt einen Preis, belegt an den Fällen oben. Agentisch ist die Stufe, hinter der Belege stehen, autonom der Warnfall. Das ist ein Konzept und keine aggregierten Kennzahlen, die Einzelzahlen sind unternehmenseigene Angaben.
Was der Umstieg kostet
Über den Gewinn schreibt jeder, der ein solches Vorhaben hinter sich hat, über die Kosten schreibt fast niemand. Eine Offenlegung, was der Weg von der klassischen zur agentischen Stufe insgesamt gekostet hat, ist von keinem Unternehmen auffindbar. Die einzigen Aufstellungen, die dazu kursieren, stammen von Häusern, die genau diese Umbauarbeit verkaufen. Eine belastbare Gesamtzahl lässt sich deshalb nicht nennen. Sagen lässt sich aber, wohin das Geld in den dokumentierten Fällen tatsächlich gewandert ist.
Der kleinste Posten sind die Modellaufrufe, denn die Einheit in diesem Strom ist eine Änderung, an der die menschliche Arbeit Minuten bis Stunden kostet. Selbst ein teurer Lauf verschwindet neben dieser Größe.
Der größte Posten sind die Bedingungen, die weiter oben schon als Voraussetzung genannt wurden, dort allerdings ohne Preisschild. Was diese Grundlage wert ist, zeigt Amazons eigener Kundenbericht. Innerhalb von Amazon, wo der Agent auf einen über Jahre gepflegten Werkzeugkasten trifft, stemmt er eine konzernweite Kampagne über 30.000 Anwendungen. Beim Versicherer außerhalb von Amazon wurde daraus eine geschätzte Beschleunigung von rund 36 Prozent. Der Finanzdienstleister musste seine internen Abhängigkeiten erst selbst aufräumen. Der Agent war derselbe, die Umgebung nicht. Diese Umgebung ist genau die Grundlage, die ein Unternehmen zuerst bezahlt, lange bevor der erste Modellaufruf abgerechnet wird.
Die Ausnahmen verschwinden auf dieser Stufe nicht, sie verdichten sich zu einem kleineren und zugleich schwereren Rest der Arbeit. Amazon berichtet, dass rund 79 Prozent des KI-geschriebenen Codes ohne weitere Änderung ausgeliefert wurden, was umgekehrt bedeutet, dass ein Fünftel nachbearbeitet werden musste. Diese Fälle sind nicht zufällig die schwierigeren, denn die einfachen hat der Agent bereits erledigt. Übrig bleibt Arbeit für erfahrene Leute, deren Zeit teurer ist als die, die eingespart wurde.
Laufende Kosten verursacht auch das Gate selbst, weil ein Entwickler jede einzelne Änderung prüft und freigibt. Das ist Personenzeit je Arbeitseinheit und keine einmalige Investition, die sich über die Jahre amortisiert.
Neu gegenüber allem aus dem Softwareeinkauf ist der Modellwechsel, denn die Mechanik um ein Modell herum kann schneller an Wert verlieren, als das Modell an Fähigkeit gewinnt. Die oben genannte Untersuchung von 2026 hat genau das gemessen, als ein schlichtes Modell ohne jede Zusatzmechanik vier spezialisierte Werkzeuge zur Testerzeugung schlug. Eine Software, die 2015 gekauft wurde, verhielt sich 2018 noch genauso, sodass sich darauf eine Investitionsrechnung aufbauen ließ. Diese Verlässlichkeit gibt es bei Modellen nicht.
Am häufigsten übersehen wird der Aufwand für die Messung, was der Meta-Fall am deutlichsten zeigt. Die eigentliche Arbeit dort steckte im Filter, der entscheidet, ob ein erzeugter Test die vorhandene Testsammlung wirklich verbessert. Ein Modell Tests schreiben zu lassen war der kleinere Teil. Ohne diesen Filter wäre das Ergebnis unbrauchbar geblieben. Wer nicht messen kann, ob etwas funktioniert, kann es auch nicht verantwortlich in Betrieb nehmen.
Was als Nächstes kommt
Idea-to-Market zeigt an einem konkreten Strom das Muster der ganzen Serie, denn Schritte verschmelzen, geprüft wird bei jeder Änderung statt am Ende und der Mensch rückt ans Gate. Der reale Gewinn hängt vom Kontext ab. Die Frage, die diese Reihe an jeden Strom stellt, ist immer dieselbe, also was an einem Schritt heute tatsächlich möglich ist und wer es gemessen hat. Diese Antwort altert schnell, deshalb steht an jeder Zahl hier ein Datum. Der nächste Beitrag legt dieselbe Brille an Issue-to-Resolution an, den Strom für Kundenservice und Störungen, wo die Erfolge und die Rücknahmen ungewöhnlich nah beieinander liegen.
Quellen
Die Zahlen in diesem Post stützen sich auf diese Quellen:
GitHub Copilot, rund 55 Prozent schneller auf der grünen Wiese: GitHub-Studie, 2022 (kontrollierte Studie, von GitHub selbst durchgeführt)
Erfahrene Entwickler rund 19 Prozent langsamer auf großem Bestandscode: METR-RCT, 2025 (unabhängige Studie)
Mehr KI-Einsatz, gemischte Ergebnisse in der Auslieferung: Google-DORA-Report, 2024 (branchenweite Befragung, veröffentlicht von Google Cloud, das eigene KI-Werkzeuge anbietet)
Amazon Q Code Transformation, rund 30.000 Java-Anwendungen und etwa 79 Prozent ohne Nacharbeit: AWS-Developer-Blog und der Amazon Q2-2024 Earnings Call (firmenberichtet), dazu unabhängige Berichterstattung
Versicherer schätzt rund 36 Prozent Beschleunigung nach Pilot mit vier Anwendungen, Finanzdienstleister aktualisiert interne Abhängigkeiten vorab von Hand: AWS-DevOps-Blog, Oktober 2024 (Kundenberichte auf Amazons eigenem Blog, vom Kunden geschätzt)
Meta TestGen-LLM, 75 Prozent bauen fehlerfrei, 57 Prozent laufen zuverlässig, 25 Prozent erhöhen die Abdeckung, 73 Prozent angenommen: Alshahwan et al., FSE 2024, arXiv:2402.09171 (Meta misst das eigene Werkzeug, Volltext frei)
Google, 7,5 Prozent aller Reviewer-Kommentare maschinell erledigt, bei rund 60 Minuten aktiver Arbeit je Änderung: Frömmgen et al., ICSE-SEIP 2024 (Google misst das eigene Werkzeug, Volltext frei)
METR ändert das eigene Versuchsdesign, Rohwerte zeigen 18 Prozent Beschleunigung bei den Entwicklern der ersten Runde und 4 Prozent bei den neu geworbenen, 30 bis 50 Prozent zurückgehaltene Aufgaben, 50 statt 150 Dollar Stundensatz: METR-Aktualisierung, Februar 2026 (unabhängige Forschungsgruppe, benennt die Grenzen der eigenen Studie)
Ein schlichtes Modell schlägt vier spezialisierte Werkzeuge zur Testerzeugung um 18 bis 21 Prozent: arXiv:2601.09695 (Benchmark auf 393 Klassen, keine Betriebsmessung)
Devin, 14 von 20 Aufgaben gescheitert: Answer.AI-Auswertung, 2025 (unabhängiger Test)


Services
Ressourcen
All Rights Reserved.